Tabla de contenidos
¿Por qué los modelos de IA aún no superan el 80% en tareas complejas?
La nueva versión de Android Bench 2.0, lanzada por Google, revela que incluso los modelos más avanzados como GPT-6 Astra alcanzan solo un 28% de aprobación en tareas de desarrollo complejo, según datos oficiales. Esto contrasta con el 90% de aprobación en versiones anteriores, donde se evaluaban cambios incrementales en repositorios existentes.
Google lanza Android Bench 2.0 con evaluación continua para tareas complejas de desarrollo
Google actualizó su herramienta de evaluación Android Bench a la versión 2.0, enfocada en tareas de gran complejidad que requieren días o incluso semanas de trabajo de un ingeniero. Ejemplos incluyen crear aplicaciones desde cero, convertir apps multiplataforma a Android o implementar nuevas funcionalidades. Esta versión reemplaza la evaluación binaria (aprobado/rechazado) con un sistema de puntuación continua que considera factores como funcionalidad, fidelidad visual y evitación de regresiones.
Modelos de IA alcanzan solo el 80% en tareas complejas de desarrollo multiplataforma
La evaluación muestra que los modelos de IA aún enfrentan desafíos significativos. Por ejemplo, portar apps multiplataforma a Android no alcanza el 100% de aprobación, y los modelos de vanguardia llegan máximo al 80% de completitud. Además, los modelos destacan en transformaciones deterministas, como convertir Java a Kotlin, pero tropiezan cuando las tareas requieren validación en tiempo de ejecución, cambios en el framework o conocimiento de bibliotecas no liberadas.
Te recomendamos: Bill Skarsgård se une al elenco de PHYSINT, la nueva obra de Kojima Productions
Android Bench 2.0 automatiza tareas complejas de refactorización de código
La versión 1.0 de Android Bench se centraba en correcciones de bugs y pequeñas solicitudes de funcionalidad. Ahora, la versión 2.0 aborda tareas que antes requerían intervención humana prolongada. Google menciona que los modelos tienen más dificultades al refactorizar código existente que al escribir nuevo, debido a la dependencia de la complejidad arquitectónica.
Qué falta por confirmar
Aunque Google compartió resultados preliminares, aún no se han publicado los detalles completos de cómo se calcula la puntuación continua. Además, no se han revelado los planes exactos para incluir combinaciones futuras de modelos y agentes en Android Bench, como se mencionó en la evaluación de agentes con Gemini 3.8 Flash en Google Antigravity y GPT-5.6 Sol con Codex.
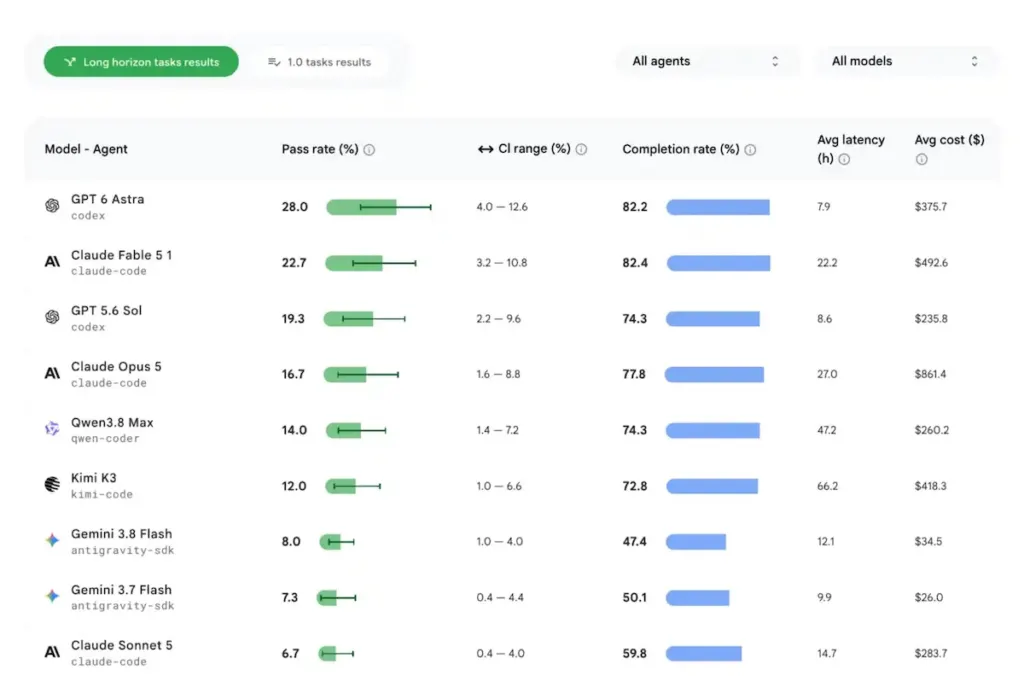
Android Bench 2.0 revela limitaciones de la IA en tareas complejas de desarrollo
Android Bench 2.0 no solo mide el rendimiento de la IA, sino que también resalta sus limitaciones. Aunque los modelos muestran habilidades sólidas en transformaciones establecidas, aún hay brechas en tareas que requieren adaptación a frameworks cambiantes o conocimiento de bibliotecas no liberadas. Para los desarrolladores, esto implica que la IA no reemplazará pronto a los ingenieros en tareas complejas, sino que servirá como herramienta complementaria en procesos específicos.
Para más contenidos como este no olvides seguirnos en nuestras redes sociales: Tiktok, Instagram y Facebook.
